摘要:部分绩效导向型的科研经费分配体系依赖由专家确定的期刊分级结果,例如芬兰出版论坛(Publication Forum,JuFo)体系。专家在评定过程中不仅参考引文指标等可获得的元数据,也结合定性判断对期刊质量进行综合评价。既有研究已尝试运用机器学习方法近似复现这类期刊分级结果,而大型语言模型(large language model,LLM)的兴起则为自动化、数据驱动的科研评价提供了新的可能。本研究考察了在向LLM提供与专家相同的结构化信息时,模型在多大程度上能够复现JuFo期刊分级。这些信息包括引文指标、学科归属、出版商相关元数据等。本研究比较了LLM预测等级与专家确定的JuFo等级,并采用混淆矩阵分析识别二者一致与偏离的情形。关注两个问题:其一,LLM能在多大程度上准确估计期刊等级;其二,在何种情况下LLM预测会偏离专家判断,以及哪些因素可能解释这些差异。研究结果表明,LLM总体上能够较高程度地接近专家赋予的期刊等级,多数错误发生在相邻等级之间。然而,模型表现具有明显的学科差异,并倾向于低估顶级期刊,尤其是在人文社科领域。
关键词:人工智能;LLM;基于绩效的研究经费制度;科研评价;GPT;Gemma
基于绩效的科研资助体系(PRFS)通过将机构经费与科研产出挂钩来分配资源并激励科研活动。负责任的文献计量学主张,定量指标应与专家判断相结合,以确保评价的学科敏感性与透明度。专家小组原则上发挥着核心作用:对定量指标进行解释和情境化处理,并对科研成果的质量与相关性作出定性判断。专家并非简单复现基于指标的排序,而是纳入其他判断标准,从而识别出那些在传统指标中未必排名靠前、但具有较高学术质量的期刊。
芬兰出版论坛(Publication Forum,JuFo)正是这一思路的代表。该体系为学术出版渠道分配质量等级。虽然该体系较好地体现了不同领域之间的差异,但也存在高度依赖专家、耗时且成本较高等问题。随着LLM的发展,本研究在向LLM提供与JuFo专家相同的结构化信息后,考察其能否模拟专家对期刊质量的判断,并分析二者的一致与偏离之处。本研究具体回答以下两个问题:
RQ1: 当获得与专家小组相同的结构化信息时,LLM能够在多大程度上准确估算期刊的等级?
RQ2: 在哪些情况下,LLM生成的等级会偏离专家赋予的JuFo等级,哪些因素可能解释这些差异?
数据集涵盖JuFo数据库中收录的全部学术期刊,排除会议论文集和图书出版商等其他出版渠道。数据基于芬兰出版论坛2022年最新一轮专家评估。经预处理后,共纳入24,841种期刊,并分别由24个学科专家小组负责评定。每种期刊均被赋予1至3级JuFo等级,等级越高表示其被认定的质量越高。第0级期刊即未达到科学出版最低标准的期刊,已从本研究分析中排除。
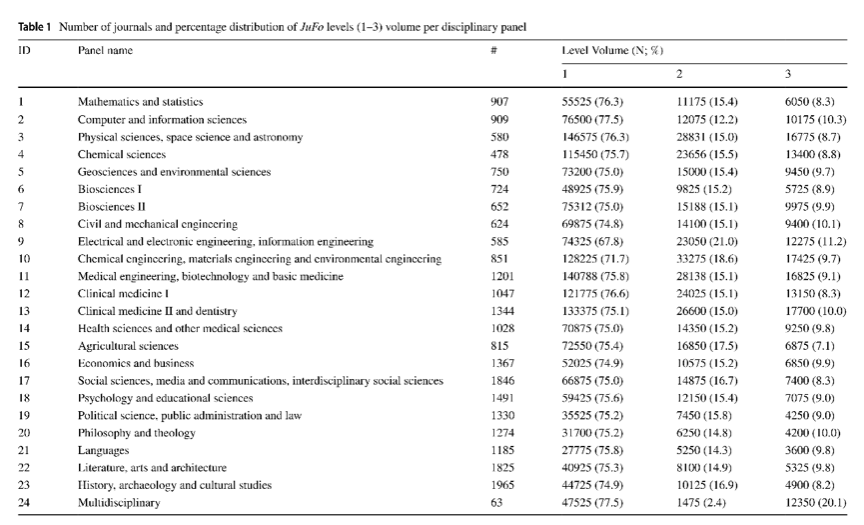
表1列出了各学科评审小组的期刊数量,以及其在三个JuFo等级上的出版量百分比分布。这些分布反映了不同学科的出版实践差异,也体现了JuFo评价体系中基于配额的结构特征。
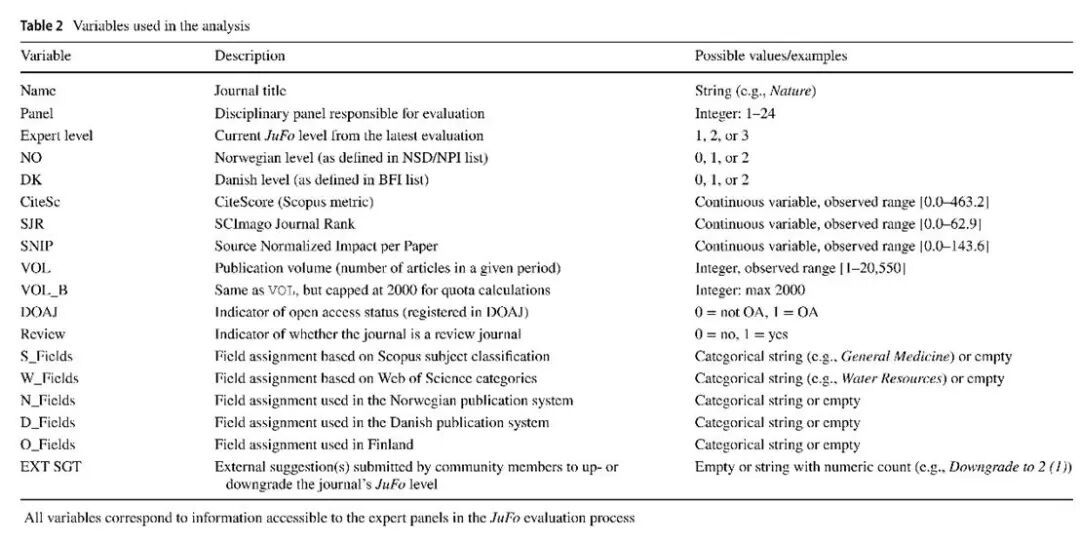
对每种期刊,我们提取了专家评审小组在评估过程中可获得的属性子集,见表2。这些变量既包括CiteScore、SJR、SNIP等文献计量指标,也包括挪威和丹麦体系中的评级、领域分类、出版量、开放获取状态,以及期刊是否主要发表综述论文等情境信息。选取与专家小组相同的属性集合,旨在确保LLM与人类评审者处于相同的信息约束之下,从而能够直接比较专家评估与LLM评估结果。
为近似模拟专家评审过程,本研究要求LLM仅依据上述结构化元数据预测每种期刊的JuFo等级。主分析采用闭源商用模型ChatGPT-4o-mini,原因在于其具有良好的可扩展性和稳定表现。作为稳健性检验,研究还在部分期刊样本上使用开源权重模型Gemma 3 27B进行评估,以考察不同模型家族之间的一致性。
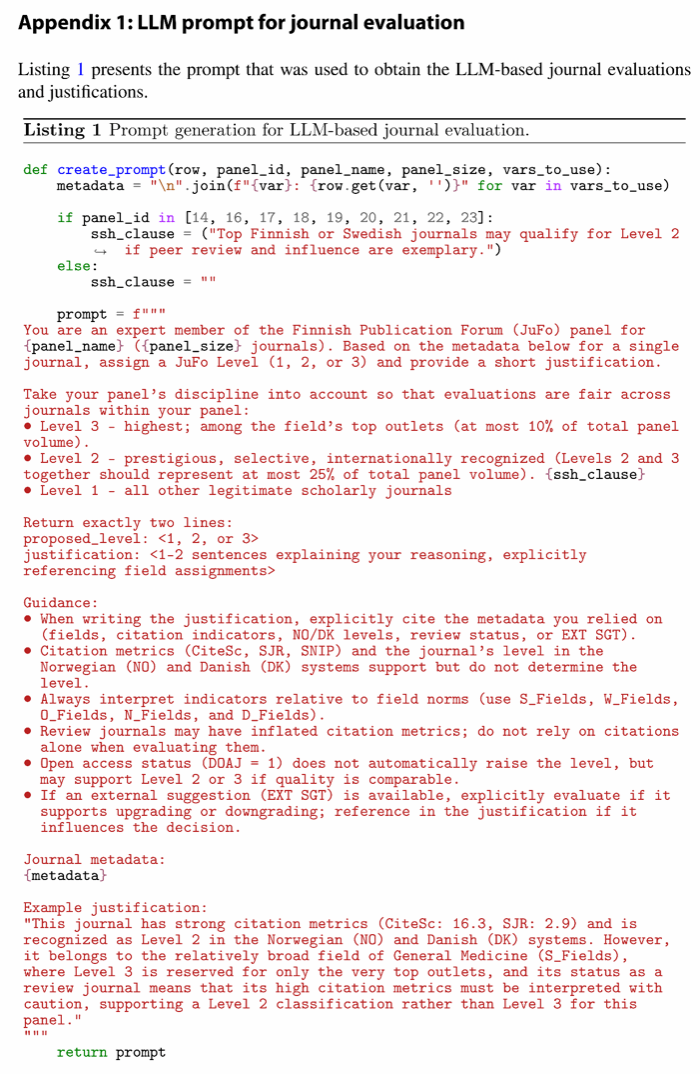
为保证可复现性并减少随机波动,所有模型均将temperature设定为0.0。模型被要求在芬兰JuFo框架下模拟专家评审者的推理过程。每个提示词均包含单种期刊的元数据,以及简要的评估标准说明,包括学科敏感性和分布约束,即超过Level 1的出版量不得超过25%,Level 3不得超过10%。随后,研究通过API逐一提交提示词,并从模型输出中提取数值化等级预测和简要判断理由。模型预测等级随后与官方JuFo等级进行比较,以量化一致性并分析不同学科和期刊特征上的系统性偏差。
为评估LLM评估与专家评估之间的一致性,本研究将各模型预测的JuFo等级与官方专家小组赋予的等级进行比较,并为每个模型构建1至3级的混淆矩阵,以直观呈现LLM评估与专家评估之间的一致情况及系统性偏差。
模型性能采用两个互补指标进行量化:准确率和宏平均F1分数。准确率反映JuFo等级总体预测正确的比例,宏平均F1分数则通过对各等级F1分数求平均,衡量模型在类别分布不均衡情况下的均衡表现。表4汇总了基于混淆矩阵计算这些指标的方法。
研究进一步比较了表3所列模型的结果,并选取宏平均F1分数和准确率最高的模型进行后续分析。对于表现最优的模型,研究重点考察其预测等级与专家赋予等级不一致的案例,分析这些差异是否集中于特定学科评审小组、出版商或基于引文的指标特征,从而揭示LLM评估偏离专家判断的情境、原因及其在科研评价中的适用边界。
在全部24个评审小组中,合并数据集包含24,855种期刊。总体而言,LLM取得了较高的整体准确率,达到0.946,宏平均F1分数为0.804,表明其在总体层面与专家赋予的JuFo等级具有较强一致性。不过,除总体准确性外,各评审小组之间也呈现出明显异质性。小组层面的准确率从第22组的0.862到第16组的0.980不等,说明模型表现随学科而呈现系统性差异。
表5列出了各等级的分类表现。Level 1期刊的预测结果高度可靠,精确率为0.976,召回率(Recall)为0.990,这反映出该等级期刊数量较大且相对同质。Level 2期刊的表现较低但仍较为稳健,F1分数为0.784。Level 3期刊则呈现出很高的精确率(0.994)和明显较低的召回率(0.476)。这一模式表明,LLM在赋予最高JuFo等级时较为保守,相较于专家小组的评估结果,往往低估Level 3期刊。
图1展示了合并数据集的混淆矩阵。多数分类错误发生在相邻等级之间,尤其集中于Level 2和Level 3之间,而Level 1与Level 3之间的混淆较为少见。这说明LLM与专家之间的分歧主要体现为边界性判断,而非根本性的评价差异。
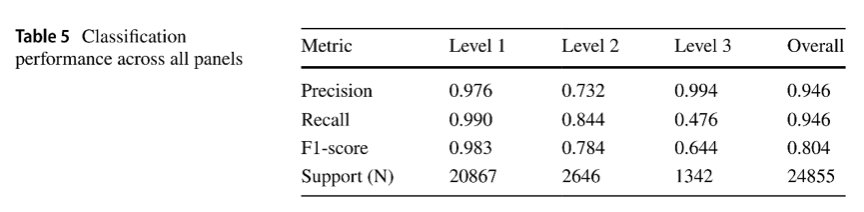
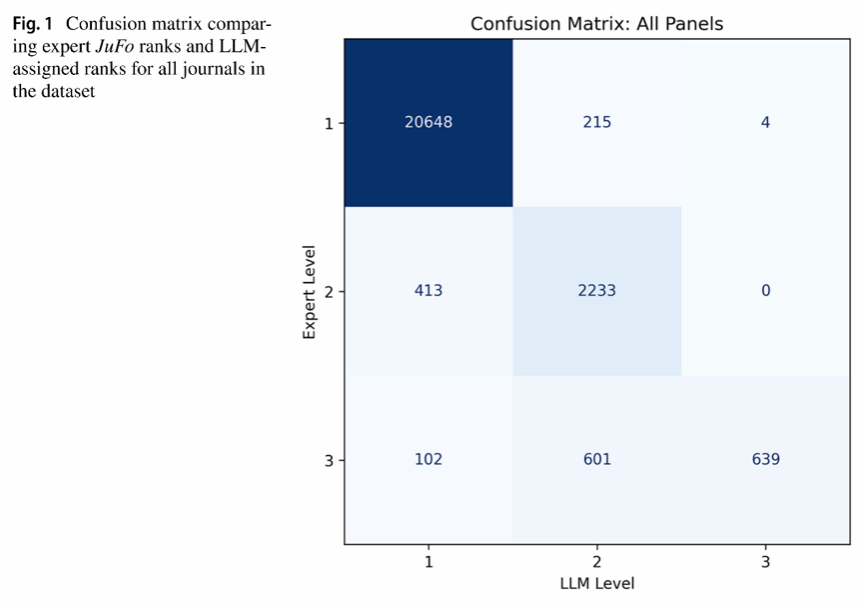
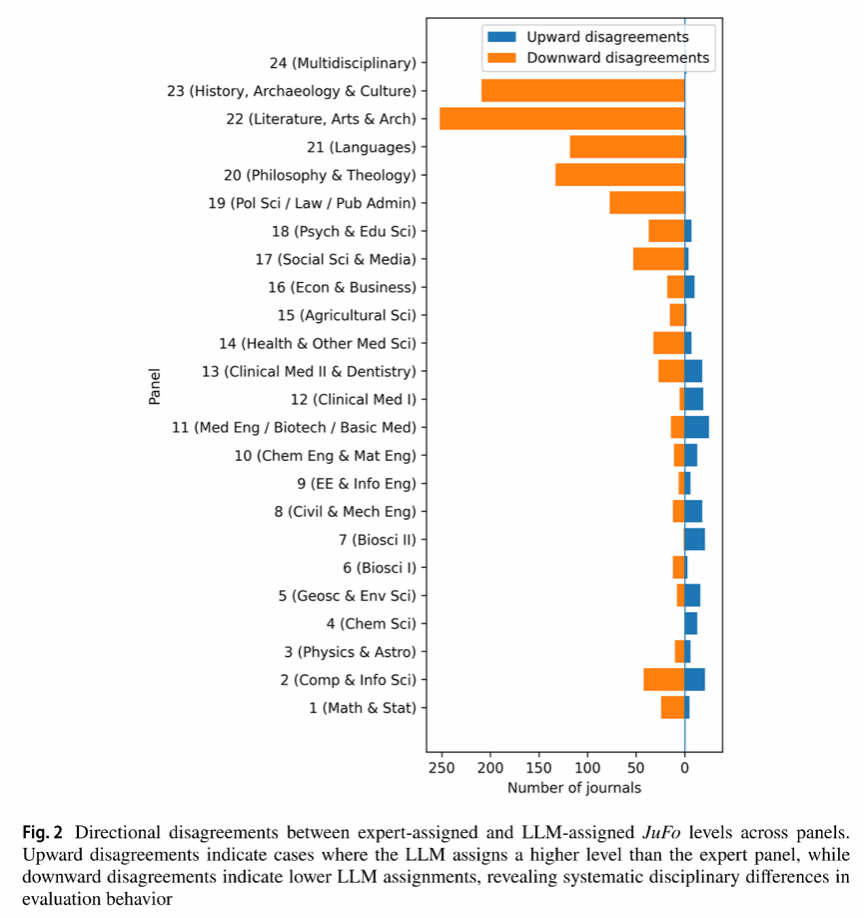
图2进一步显示,不同学科中的分歧方向存在明显差异。若干人文社科评审小组主要表现为下行分歧,即LLM赋予的等级低于专家小组;相反,部分传统上引文密集和生物医学相关领域则呈现相反趋势。这些系统性差异具有理论意义,因为它们与JuFo专家小组制度设立的初衷高度一致:科研质量无法在所有学科中仅凭统一的文献计量信号加以推断。
总体而言,结果表明尽管LLM评估能够在大规模情境下较好逼近专家判断,但其错误并非随机分布。相反,分歧模式反映了学科差异,因而在科研评价中应用LLM时,仍需重视基于评审小组的校准和具有学科敏感性的评价标准。
为补充上述总体结果,本节选取两个JuFo评审小组进行案例分析。这两个小组代表了不同的学科评价制度:其一是具有标准化出版形式和较强引文信号的计算机与信息科学(第2组);其二是更依赖解释性和情境性标准的人文学科领域,即历史、考古学与文化研究(第23组)。这些分析并非旨在全面覆盖所有领域,而是用于揭示专家JuFo分类与LLM评估之间的典型一致模式和特征性分歧。
第2组(计算机与信息科学)包括909个学术期刊。总体来看,LLM的准确率为0.931,宏平均F1分数为0.779。图3展示了该组的混淆矩阵,表6总结了各等级的精确率、召回率和F1分数。
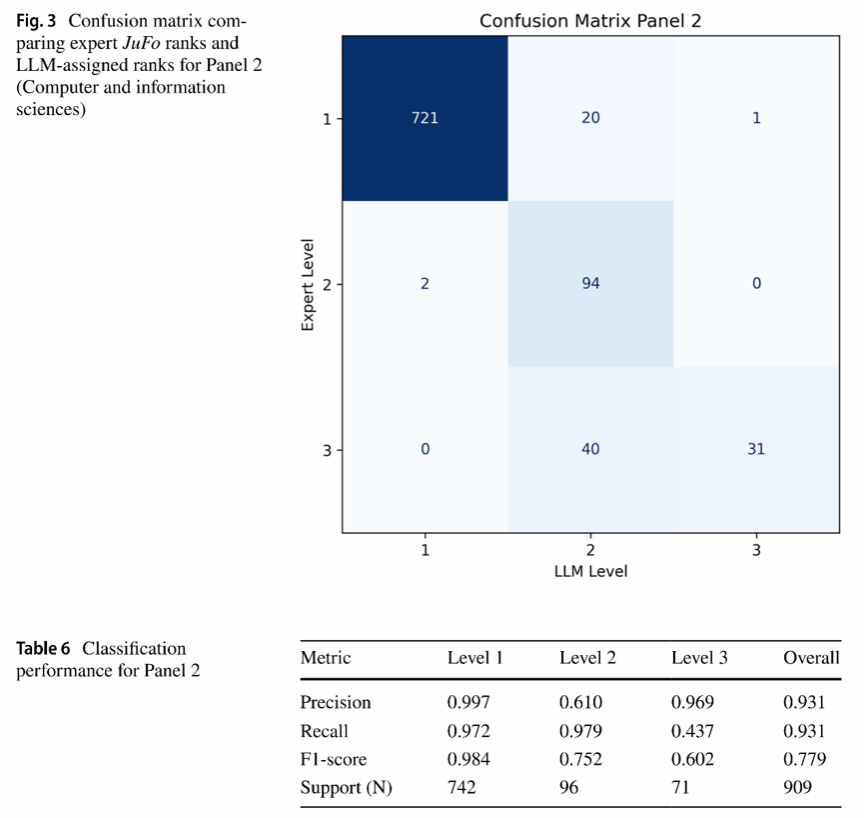
混淆矩阵显示,LLM对Level 1的判断与专家高度一致。Level 1的精确率和召回率均超过0.97,说明在这一高度标准化的领域中,LLM对较低等级期刊的判断与专家意见高度吻合。Level 2期刊的表现较为复杂,而Level 3期刊则表现为精确率较高但召回率明显偏低,说明相较于专家小组,LLM倾向于漏判顶级期刊。
对分歧案例的定性考察进一步显示了LLM所采用的评价启发式。例如,《IEEE Transactions on Artificial Intelligence》被专家小组评为Level 1,却被LLM判为Level 3。模型在其判断理由中将该刊描述为计算机与信息科学重要子领域中的领先期刊,并明确依据其在学科中可能处于前10%的地位来支持Level 3判断。这一推理表明,即使缺乏明确的引文信息,LLM也会依据可见性、主题中心性和感知到的学科影响力来推断期刊质量。
然而,从JuFo专家评估的角度看,这些标准并不足以支持Level 3分类。Level 3反映的是更为严格且具有历史积淀的声望和选择性判断。由此产生的分歧表明,LLM存在将新兴显著性和主题相关性等同于顶级地位的倾向,从而相较于专家判断高估了某些期刊。
部分专家评估与LLM评估之间的差异,也可归因于评审小组层面的评价实践。专家小组被要求考虑小组内部不同研究领域之间的平衡与公平。尽管提示词明确要求模型按照领域规范解释指标,并考虑特定领域的声望结构,但部分分歧仍然存在。这说明,一些差异,尤其是信息系统和软件等较大子领域中的差异,可能反映了专家小组工作中内在的领域平衡考量,而不完全是对单个期刊质量感知的差异。
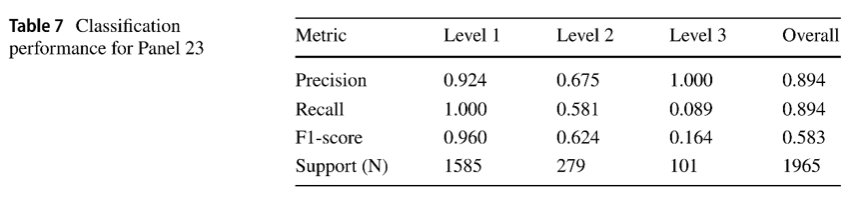
第23组(历史、考古学与文化研究)包括1,965个学术期刊。总体而言,LLM的准确率为0.894,宏平均F1分数为0.583。图4展示了混淆矩阵,表7总结了各等级的精确率、召回率和F1分数。与第2组不同,第23组的表现呈现出明显的等级不对称。Level 1期刊能够以很高的召回率被识别,而Level 3期刊的召回率仅为0.089。这一模式表明,模型明显倾向于低估人文学科中的高声望期刊,实际上将许多Level 3期刊归入较低等级。
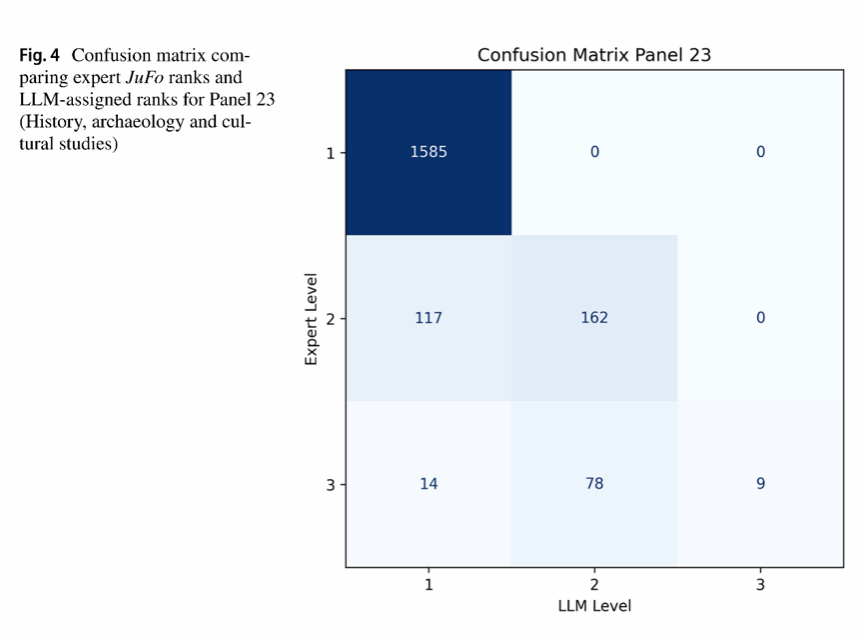
对具体分歧案例的考察表明,第23组中的不对称性具有系统性而非偶然性。LLM几乎不存在上行分歧,即赋予高于专家小组的JuFo等级;错误主要表现为下行分类,说明其在识别人文学科Level 3期刊时采用了较为保守的阈值。
例如,《Transactions of the Royal Historical Society》被专家评为Level 3,却被LLM归为Level 1。模型理由强调其引文指标较低、缺乏明确的前10%定位,虽承认其在北欧分类体系中具有一定认可度,但较少体现其机构性作用和历史声望。类似地,《Critical Inquiry》被专家评为Level 3,而LLM仅评为Level 2。尽管模型承认其国际可见性和学术影响力,但仍因引文指标和比较性排名不足而未赋予最高等级。这表明专家评估更重视思想引领和议程设置影响,而LLM更依赖可量化的卓越性标准。
这些发现凸显了专家小组在科研评价中的持续重要性。第23组中LLM分类困难,与早期机器学习和文献计量方法在期刊分级中的局限相似。在缺乏强有力或清晰量化指标时,自动化系统往往给出保守评级,难以识别那些声望根植于学科规范、历史意义或学术领导力,而非引文表现的高声望期刊。人文学科中SJR、SNIP等标准化指标缺失或信息量不足,也加剧了这一问题。尽管提示词要求模型结合领域规范进行判断,但结构化量化信号不足仍会对人文社科中的LLM评估产生明显影响。因此,LLM虽具备较高一致性和可扩展性,但仍难以充分捕捉难以形式化的学术质量,专家评估在此类领域中依然不可替代。
为检验结果对于模型选择的稳健性,研究使用Gemma 3 27B进行了有限比较,并以ChatGPT-4o-mini作为GPT系列评估模型。由于Gemma 3 27B推理延迟较高且受token速率限制,无法覆盖全部评审小组,因此仅在若干代表性小组上使用相同提示词和评估条件进行对比。
比较范围涵盖引文密集且技术标准化程度较高的第3组和第9组、较小规模的第24组、人文社科的第21组和第23组,以及中等规模的第15组。如表8所示,在所有被评估小组中,ChatGPT-4o-mini与专家赋予的JuFo等级一致性均高于Gemma 3 27B。最大差距出现在第3组和第9组;在这些出版实践标准化、引文信号较强的领域中,ChatGPT-4o-mini与专家判断高度一致,而Gemma 3 27B表现明显较弱。第15组和第24组也呈现类似趋势。第21组和第23组中,两种模型整体一致性均较低,但ChatGPT-4o-mini仍持续优于Gemma 3 27B。
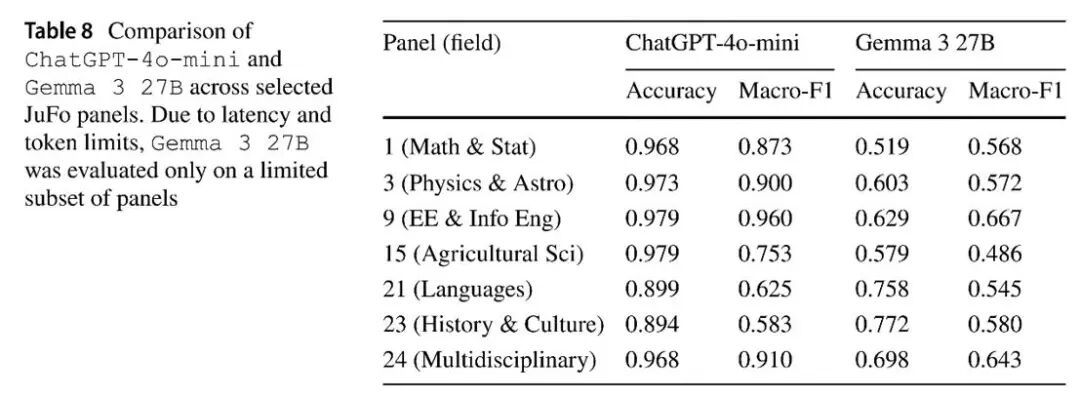
总体而言,GPT系列模型与专家JuFo等级的高度一致性并非所有LLM的普遍属性。模型表现还取决于模型架构、训练情况,以及其对复杂且具有学科敏感性的评价标准的适配程度。这说明,在将LLM作为科研评价决策支持工具时,模型选择至关重要。
本研究结果表明,LLM能够在国家期刊分类系统中近似专家判断。使用ChatGPT-4o-mini对所有评审小组的期刊进行评估时,模型取得了较高的整体准确率(0.946)和较强的宏平均F1分数(0.804),且其表现随学科而呈现系统性差异。这些发现与既有研究一致,说明LLM能够生成与专家评估正相关的研究质量估计,并在许多情况下优于基于引文的指标。
针对具体学科小组的分析显示,分类错误主要发生在相邻等级之间,并且在引文密集度较低的学科中,尤其是在人文社科中,模型倾向于低估最高等级。值得注意的是,即便模型已被明确提示:若同行评议和影响力表现突出,芬兰或瑞典的顶级期刊也可被评为Level 2,这种低估现象仍然存在。这些模式反映了JuFo体系中已知的领域特定评价挑战,也与既有关于人文社科出版模式的研究相一致。相关研究指出,该领域的异质性、多语言性和出版类型多样性,是跨学科和跨国家情境下评价研究质量时必须考虑的重要因素。
这些结果表明,LLM可以作为期刊分类的有效决策支持工具,用以补充人类专家判断,但不能完全替代专家。尤其重要的是,为每一项LLM输出提供透明的推理过程和判断理由,对于提升信任、可解释性和用户接受度至关重要。这种对透明性的强调,与近期提出的将LLM与结构化科学计量表示,如知识图谱相结合的框架相一致。此类框架有助于在研究评价中形成更具情境化、可解释性和交互性的分析。同时,AI生成的质量指标可能引入未知偏见,并影响研究者行为,因此必须保持审慎的人类监督。
与以往通常通过汇总论文层面的判断来推断期刊质量的研究不同,本研究向LLM提供了与专家小组相同的结构化证据基础,包括引文指标、北欧排名、出版量、开放获取状态,以及期刊是否主要发表综述类文章。研究目的在于评估LLM是否能够在期刊层面内化并应用复杂的、具有领域特定性的评价标准。各评审小组之间表现不均衡,说明LLM评价既具有潜力,也存在局限:在引文信号较强的学科,如电气与电子工程、信息工程中,模型与专家小组判断较为一致;而在人文社会科学等学术质量较难形式化的领域,LLM评价仍面临较大挑战。
值得注意的是,评审小组之间的差异也引发了自动化研究评价中的学科公平性问题。模型表现在不同领域中的系统性差异表明,单一、统一的模型配置可能偏向出版形式更标准化、引文信号更强的学科,而使其他学科处于相对不利的位置。从负责任研究评价的视角看,这些差异也与近期关于LLM指标不透明性、不稳定性及其潜在行为影响的讨论相呼应。因此,在将LLM作为研究评价决策支持工具时,必须开展具有学科敏感性的验证,并保持审慎的人类监督。
总体而言,本研究结果支持基于LLM的方法在期刊评价中扩展并补充专家驱动的评价过程,同时也强调,在学科规范和情境知识对质量判断至关重要的领域,人类判断仍然不可或缺。
(全文及参考文献见Scientometrics,原文链接:https://doi.org/10.1007/s11192-026-056,本期推文为节选摘编,略有删减和编辑。)
本期策划 | 复旦大学国家智能评价与治理实验基地
供稿 | 王萱瑜 王译晗
本期编辑 | 王萱瑜
基地官网:https://statevalbase.fudan.edu.cn