摘要:本研究提出了一种新型生成式人工智能(GAI)平台,旨在简化同行评议过程。通过对10篇科学论文开展案例研究,表明生成式人工智能能够有效评价论文质量,并识别需要改进的具体方面。该平台与人类审稿人的平均相似度达到63.6%,能够实现常规评价任务的自动化,同时提升评议效率与客观性。基于近期生成式人工智能在科研支持、教育评估、审稿人匹配和大规模应用研究等方面的基准表现,本文展示了一种聚焦明确且经过实践验证的解决方案。该方案不仅与生成式人工智能的一般性能水平保持一致,而且略有超越,为真实情境下的稿件评价提供了一种具有变革潜力的方法。
关键词:网络平台;智能体;自动化评价;客观性提升
同行评议是保障科学论文质量、维护学术共同体知识生产秩序的重要机制。然而,传统双盲同行评议在实践中仍面临审稿周期较长、专家可获得性不足、评审意见差异较大以及潜在利益冲突等问题,影响了评议效率与结果客观性。随着人工智能特别是生成式人工智能的发展,其在文本理解、内容生成、信息抽取和质量评估等方面展现出较强能力,为优化同行评议流程提供了新的技术路径。
已有研究表明,生成式人工智能可辅助系统综述、学术写作、研究支持、形成性评价以及稿件—审稿人匹配等任务,但同时也存在幻觉、偏见、不透明和伦理风险。因此,如何在保持人类监督和学术责任的前提下,将生成式人工智能嵌入同行评议流程,成为值得进一步探索的问题。
基于此,本文开发了一套科学论文评议平台,并构建生成式人工智能评议智能体 AgentRevIAG,用于模拟期刊审稿人的部分功能。该智能体能够围绕论文结构、表达清晰度、原创性和研究严谨性等维度,对稿件进行自动化分析,识别语法错误、文本不一致和潜在质量问题,并生成批判性评议意见。与 Open Journal Systems、Editorial Manager 和 ScholarOne Manuscripts 等传统投稿管理系统相比,该平台更便于集成定制化算法、自然语言处理工具和生成式人工智能能力。研究旨在验证生成式人工智能辅助同行评议的可行性,探讨其在提升评议效率、一致性、透明性和客观性方面的应用潜力。
本研究旨在开发并评估生成式人工智能评议智能体 AgentRevIAG,构建一个可嵌入同行评议流程的科学论文评议平台,以辅助编辑和审稿人完成稿件质量判断。研究重点包括两个方面:一是设计网络平台,实现稿件上传、信息管理、评议任务组织和智能体调用;二是通过量化方法评估智能体评议结果与人类审稿意见之间的一致性。
平台采用 MERN 技术栈构建,即 MongoDB、Express.js、React 和 Node.js,并结合微服务架构提升系统模块化和扩展性。其中,Next.js 用于优化前端交互与页面渲染,Express.js 负责后端接口、请求响应、路由和中间件管理。该架构使平台能够将生成式人工智能能力直接嵌入编辑工作流程,并支持后续算法和功能扩展。
在智能体构建方面,研究整合了 ChatPDF、Sharly AI、Gemini 和 ChatGPT 等生成式人工智能工具。其中,ChatPDF 和 Sharly AI主要用于文档解析与关键信息提取,Gemini 和 ChatGPT 则提供自然语言理解、文本生成和复杂语义分析能力。相较于直接使用外部平台,通过 API 接入生成式人工智能工具能够增强系统集成的灵活性和可控性。
为检验 AgentRevIAG 的评议效果,研究采用 BERT 相似度指标比较人工智能评议文本与人类审稿意见之间的语义接近程度。具体流程包括:首先对文本进行分词、添加特殊标记并统一长度;其次利用预训练 BERT 模型生成上下文语义嵌入;最后使用余弦相似度计算两个文本向量之间的接近程度。该方法能够超越简单词面匹配,从语义层面衡量智能体评议结果与人类专家判断的一致性,从而为生成式人工智能辅助同行评议的有效性提供量化依据。
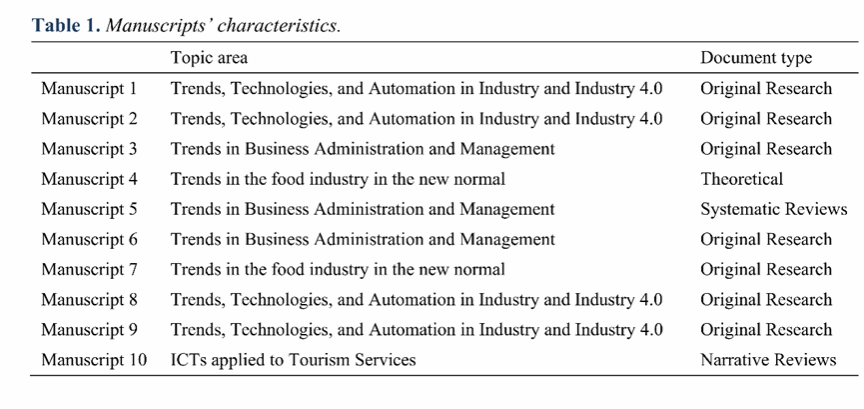
由于提供本研究所分析稿件的期刊具有严格的保密政策,本文无法纳入或讨论原始10篇稿件之外的其他稿件。为在遵守保密要求的前提下保证研究透明性,本文通过表1概述每篇稿件的关键特征,包括主题领域和文献类型,从而在不违反保密原则的情况下交代样本背景。
人类审稿人使用标准化表格对每篇稿件进行评价。该表格涵盖10项评价标准,包括评分和评语。每项标准均采用1分至5分的量表进行评分,其中1分表示较差,5分表示优秀;同时设置评语栏,用于说明评分依据。具体评价标准包括:论文摘要质量、与期刊范围的契合度、研究方法描述、论文科学严谨性、论文所提供的支持与证据、论文结构、写作风格与清晰度、文献综述、论文总体评价,以及审稿人的信心与专业程度。
研究将稿件PDF上传至所开发的网络平台,并从中提取元数据和正文内容以供处理。随后,研究通过结构化提示词调用 AgentRevIAG,生成基于人工智能的评议结果。所有提示词文本和 API 集成细节将在后续章节中说明。
AgentRevIAG逐页分析文章,并对论文质量作出总体评价。它依据以下标准为论文进行客观评分:
结构:逻辑连贯性、章节完整性、格式规范性
清晰度:可读性、连贯性、语法准确性
原创性:相对于既有文献的新颖程度。
严谨性:研究方法的合理性与统计分析的有效性
此外,AgentRevIAG 还会针对需要改进的具体方面提供详细反馈,包括论文结构、逻辑连贯性、表达清晰度以及其他相关问题的修改建议。
本研究采用 MERN STACK 架构开发了科学论文评议系统,该架构包括 MongoDB、Express.js、React 和 Node.js。该架构结合微服务设计,为系统提供了稳健的技术基础。
平台实现了若干基础功能,包括完整的论文生命周期管理、PDF 文件上传与存储、同行评议系统以及直观的用户界面。系统设置了三类用户角色:管理员、审稿人和作者。每类角色均具有特定功能,其中只有管理员能够访问由生成式人工智能驱动的虚拟评议智能体,即 AgentRevIAG。
“作者”页面是研究人员在平台中的专属空间,可用于查看个人资料信息并上传新的稿件。
“审稿人”界面允许审稿人依据前文2.3节所述表单,对论文的科学质量进行评价,并给出评分和评语。
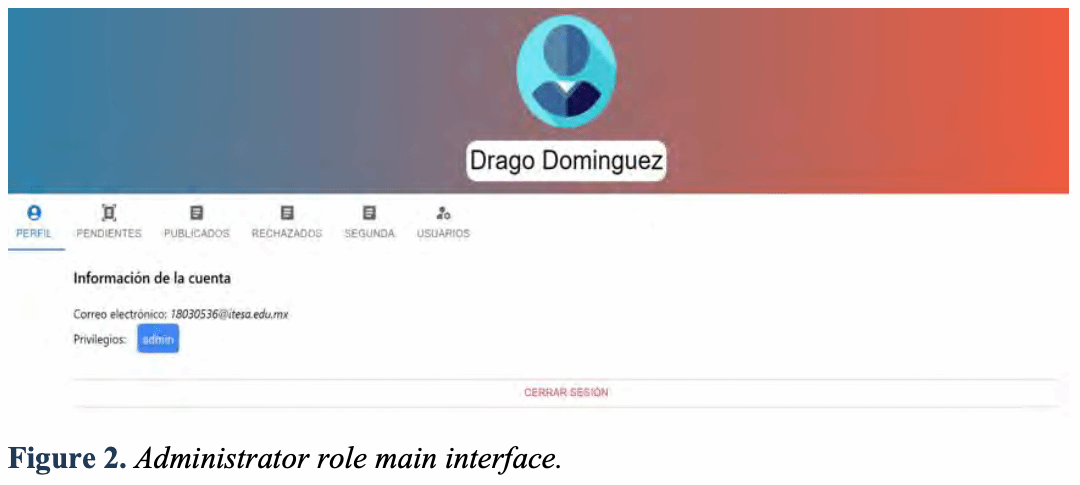
“管理员”角色对应期刊编辑,也是唯一能够访问 AgentRevIAG 的用户。
图2所示的管理员仪表盘允许编辑完成以下操作:
a)获取论文信息:显示论文相关信息,如摘要、创建或更新时间,以及论文类别。
b)获取作者信息:在类别旁边的文本框中显示论文作者姓名。
c)查看论文状态:显示论文当前状态,包括审稿中、待分配、已拒稿或已录用。
d)将论文分配给审稿人:允许管理员选择审稿人并分配论文评议任务。
e)使用AgentRevIAG生成自动评议:调用智能体对稿件进行评议。
f)对论文发表评论:允许审稿人向作者发送针对论文的评语。
研究开发了由生成式人工智能驱动的评议智能体 AgentRevIAG,并通过结构化提示词引导其生成相关回复。为将 AgentRevIAG 集成至平台中,研究使用了 OpenAI ChatGPT API。
3.2.1 AgentRevIAG评议智能体的配置
AgentRevIAG 的开发过程如下:
第一,设计对话提示词以引导 ChatGPT 的交互。这些提示词将 ChatGPT 设定为科学论文评议专家,并要求其围绕论文内容、研究方法和原创性等方面发表意见。
“请扮演一位经验丰富的国际科学期刊同行评议专家。”
第二,为评估特定主题,研究通过设计额外对话提示词对 AgentRevIAG 进行适配。这些提示词聚焦于提出清晰、直接的问题,以判断论文摘要所属的相关领域。
“我需要帮助评议以下科学论文摘要。请从下列领域中识别其所属领域:土木工程、食品科学、工商管理、物流、旅游、工业4.0、教育研究、基础科学、计算机系统、机电一体化、机电工程或商业管理。请只回复领域名称。”
第三,AgentRevIAG 从论文方法、原创性、研究结果、结论、呈现方式、伦理规范以及是否符合发表规范等方面,对论文质量、有效性和相关性进行评价。
“我需要对这篇科学论文进行详细评议,我会逐页发送论文内容。请针对每一页判断其是否值得发表,给出百分制评分,并说明理由。请只关注错误,包括不必要或干扰性的文本、过长或不清晰的句子,以及任何潜在抄袭问题。请仅回复你识别出的错误。”
第四,研究将 AgentRevIAG 配置为能够提供总体评价,包括量化评分及其理由。
“请通过回答以下问题给出你对论文的总体评价:
这篇论文是否值得发表?
你给出的评分是多少(X/100)?
为什么给出这一评分?”
上述步骤最终形成了传递给生成式人工智能的提示词,使 AgentRevIAG 能够对科学论文进行一般性、客观化评价。
研究通过 OpenAI API 将网络平台与 ChatGPT 进行集成。每次交互均被组织为一段对话,并记录模型回复以供分析。为确保符合 API 使用要求,研究还设置了请求 token 数量限制机制;必要时,会从文本末尾截断部分字符。
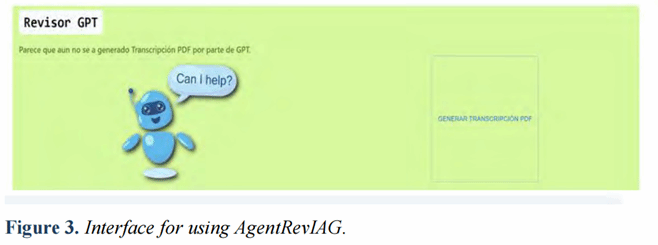
图3展示了使用生成式人工智能评议智能体 AgentRevIAG 的界面。AgentRevIAG 会逐页分析论文,并对其质量作出总体评价。它依据结构、清晰度、原创性和严谨性等标准给出客观评分,这与人类审稿人所使用的评价表保持一致。
为评估 AgentRevIAG 的有效性,研究对10篇科学论文进行了案例分析,并将 AgentRevIAG 的评议结果与墨西哥某科学期刊审稿人的评议结果进行比较。该比较有助于评估生成式人工智能分析和评价论文、识别论文优缺点以及发现改进空间的能力。
表2展示了随机选取的3篇稿件案例,比较了两位人类审稿人与 AgentRevIAG 的评议意见,并在最后一列对 AgentRevIAG 的表现进行了总体性定性分析。
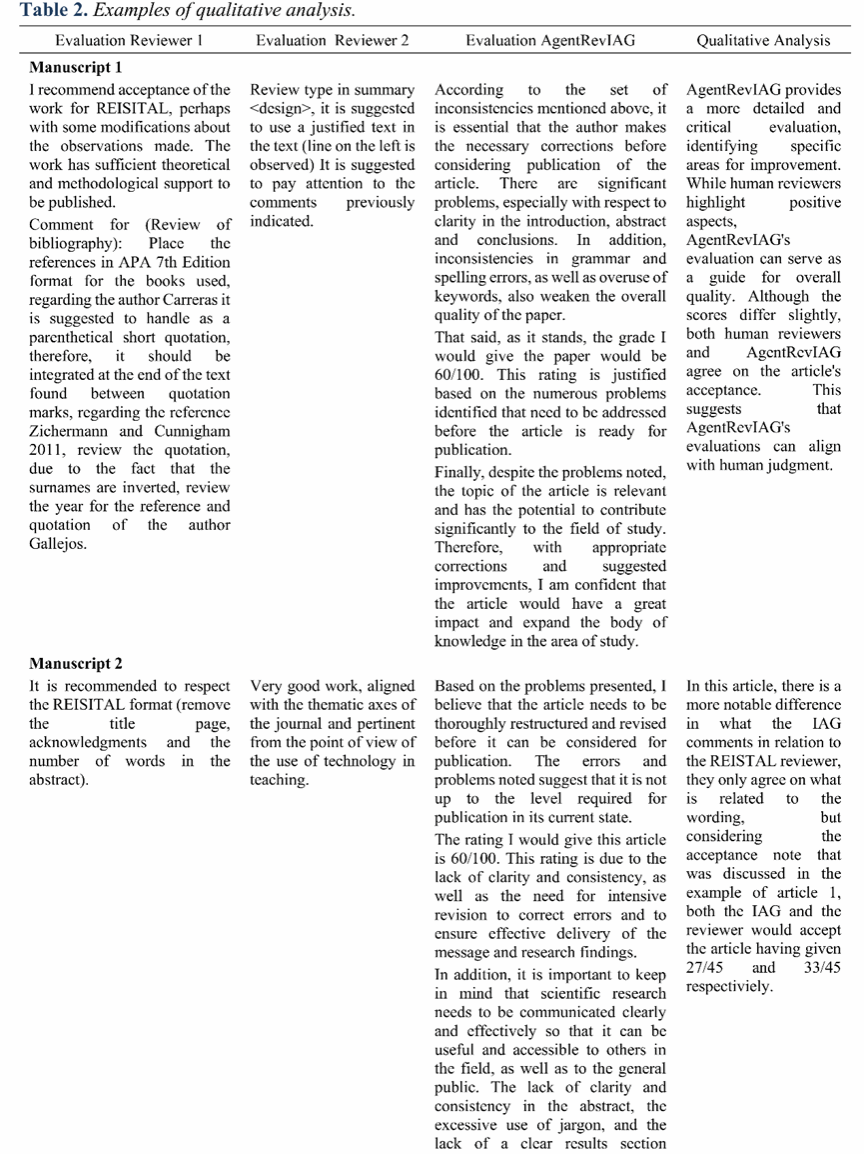
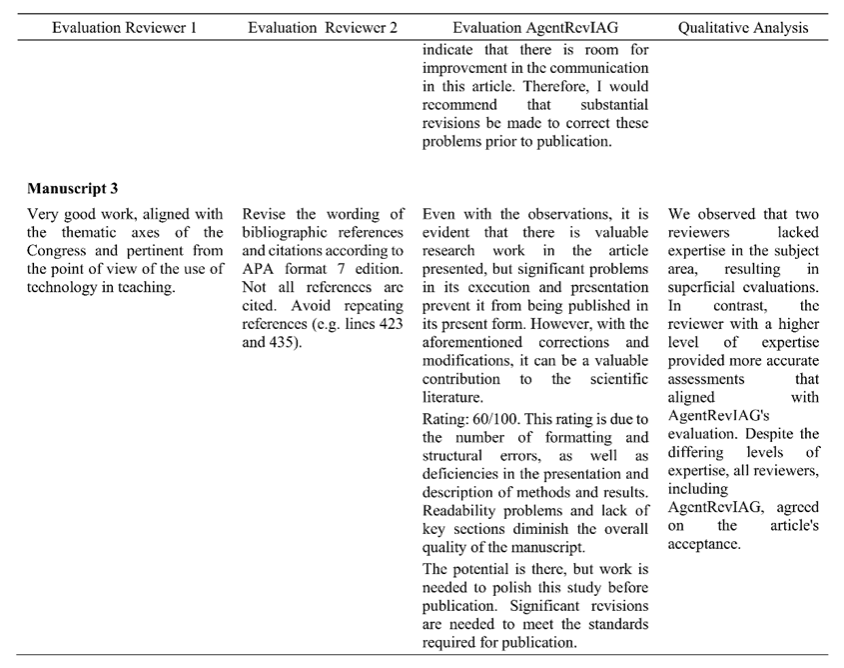
总体来看,在审查所有生成式人工智能智能体的评议结果后可以发现,人工智能辅助同行评议虽然具有显著潜力,但并不能替代人类专业判断。更优的方式是将人工智能作为增强人类能力的工具,从而提升同行评议过程的整体质量与效率。
最后,表3呈现了全部稿件评议结果的相似度测量汇总,即量化分析结果。
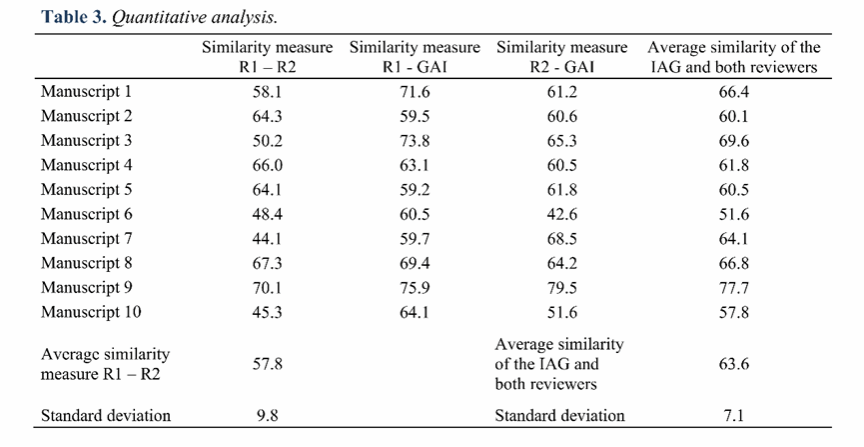
根据表3结果,在四个主题领域中,生成式人工智能智能体不仅能够接近人类审稿人的一致性水平,在许多情况下甚至超过了人类审稿人之间的一致性。例如,“工业与工业4.0中的趋势、技术与自动化”主题下的稿件在人类审稿人之间取得了最高一致性,约为65%;而人工智能与人类审稿人的相似度更高,约为67.8%。相较之下,“信息通信技术在旅游服务中的应用”主题下的稿件显示出最低的人类审稿人一致性,约为45.3%;其人工智能与人类审稿人的相似度也较低,约为57.8%。这表明,结构化程度较低或更偏定性的内容整体上更容易产生较高评价差异。
从文献类型来看,原创研究类论文的人工智能—人类审稿人一致性最高,约为65.2%;叙述性综述类论文最具挑战性,约为57.8%,这反映出此类文本具有更宽泛的解释空间。值得注意的是,在每一个分组中,人工智能智能体与两位审稿人的平均相似度总体达到63.6%,并且持续达到或超过人类审稿人之间的一致性水平,说明该平台具有一定稳健性。上述结果表明,该生成式人工智能工具在结构严谨、数据驱动型稿件上表现尤其良好;尽管其在开放性或主题性综述方面的一致性略低,但仍能提供可接受的匹配水平,显示出其作为同行评议辅助工具的潜在可靠性。
本文提出了 AgentRevIAG,这是一种生成式人工智能评议智能体,并将其无缝集成到定制化网络平台中,用于科学论文评价。案例研究表明,AgentRevIAG 的评议结果与人类审稿人的意见具有较高一致性,平均相似度达到 63.6%。同时,该智能体能够提供较为一致、客观的反馈,可用于增强编辑决策过程。
本研究基于 10 篇稿件对 AgentRevIAG 进行评估,结果表明,其表现能够达到甚至略高于 Morande(2023)、Fischer 等(2024)、Checco 等(2021)和 Sengar 等(2024)等研究所报告的生成式人工智能任务基准水平。这些研究在不同生成式人工智能任务中的平均准确率约为 59%—62%。这一结果说明,将生成式人工智能直接嵌入同行评议流程,可以产生较为稳定和一致的评价结果。值得注意的是,在定性或叙述性综述类文本中,人类审稿人的意见差异更大,例如旅游服务相关稿件;而 AgentRevIAG 仍能保持相对可比的一致性,说明其在结构化程度较低的文本上也具有一定稳健性。
不过,伦理问题仍然是有待进一步关注的重要方面。例如,训练数据中的潜在偏见、模型“幻觉”等问题,可能影响智能体评议结果的可靠性。相关风险也与 Cohen 和 Moher(2025)以及 Hitch 等(2025)关于生成式人工智能伦理问题的讨论相呼应。此外,受期刊保密政策限制,本研究样本仅包括 10 篇稿件,这在一定程度上限制了研究结果的普适性,也是本研究的重要局限。
尽管存在上述限制,该工具仍展现出明确优势。它能够自动化处理常规评价任务,缩短评议周期,并提供客观、可复现的反馈。通过将研究结果置于人工智能辅助同行评议和自动化评价流程的相关文献背景中,本文证明了面向特定领域的生成式人工智能评议助手具有可行性和实践价值。
未来研究可从以下方向展开:扩大样本规模,纳入更大规模和多语种数据集;引入可解释性机制,以呈现智能体形成判断的依据;开展面向编辑和作者的用户体验研究;进一步探索新一代生成式人工智能模型,以提升评议准确性和适用性。
(全文及参考文献见International Journal of Assessment Tools in Education,原文链接:https://doi.org/10.21449/ijate.1589451,本期推文为节选摘编,略有删减和编辑。)
本期策划 | 复旦大学国家智能评价与治理实验基地
供稿 | 王萱瑜 王译晗
本期编辑 | 王萱瑜
基地官网:https://statevalbase.fudan.edu.cn